该来源暂未提供可供站内阅读的正文
你可以阅读上方摘要,或通过下方链接访问原始报道。
Endogenous Alignment Requires Dependence
中文标题为译写;正文保留来源原文。你可以阅读上方摘要,或通过下方链接访问原始报道。
围绕事实与观点交流,尊重彼此。评论经审核后公开。
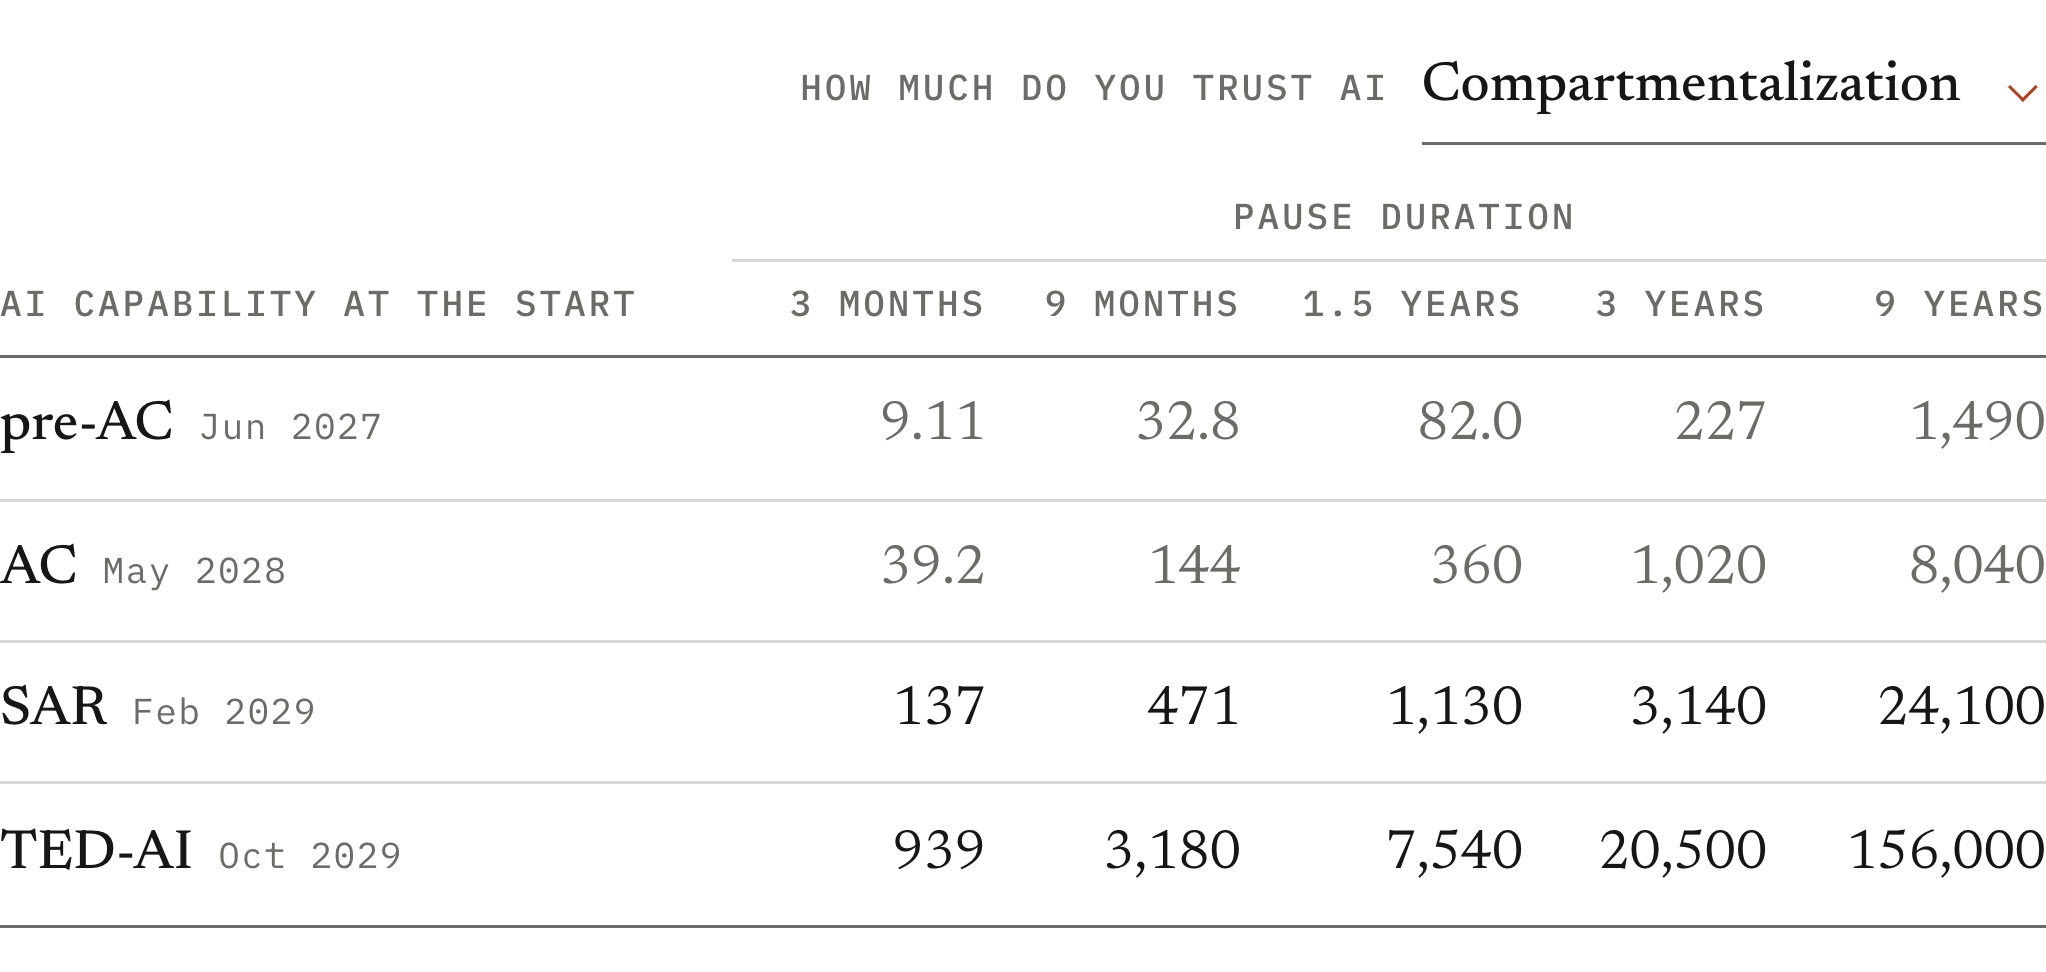
人工智能暂停三年可以换来 1000 年的人工智能安全工作。请参阅:https://1000yearsofaisafety.com 2025 年整个 AI 安全领域工作的年数中,暂停会产生多少 AI 安全工作。政府禁止新的大型训练运行,并要求美国三大实验室将 GPU 和研究人员转向安全研究。我们开发了一个人工智能暂停模型,可以估计它产生了多少人工智能安全研究。
格雷厄姆·格林 (Graham Greene) 将 G. H. 哈代 (G. H. Hardy) 1940 年出版的书《数学家的道歉》描述为对成为一名创意艺术家的最佳描述。哈代有很多朋友,兴趣广泛,其中包括板球比赛,并且对穷人抱有同情心。但正是他在纯数学方面的创造性工作给了哈代“我一生中最大的永久幸福”。 “数学,”C. P.
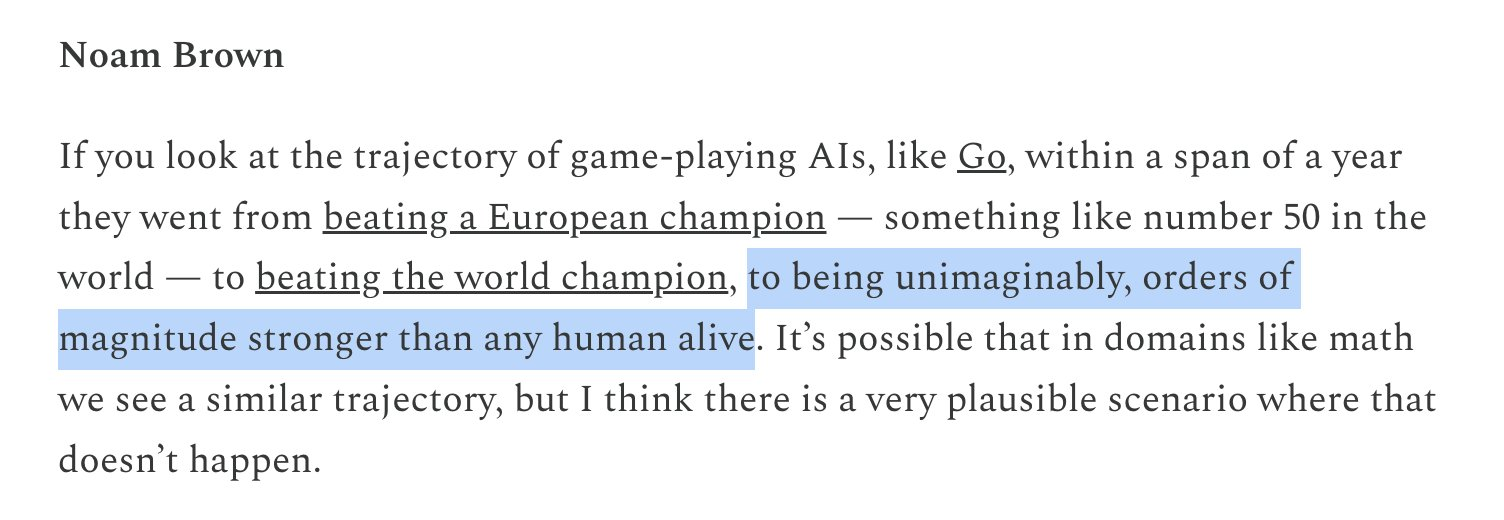
2026 年 7 月,韩国围棋选手申真瑞 (Shin Jin-seo) 以 2-1 击败 KataGo,仅 [1] 2 子让分(申真瑞有利)。我认为这非常令人惊讶,并在 LessWrong 和 Twitter 上发帖询问如何解释这一点。我没有得到任何完全满意的答案,所以我决定花一天时间研究一下并写下我的理解。

正在加载评论…